Vector Index Benchmark
GIST1M과 SIFT1M에서 AkasicDB Hierarchical Navigable Small World (HNSW), Vamana, DiskANN과 pgvector·Milvus HNSW의 Recall@10–QPS를 측정했습니다. AkasicDB quantization과 DiskANN은 Enterprise Edition 기능입니다. Index 생성과 query 예제는 Compare Index Families를 참조하십시오.
Methodology
Dataset별 query vector 순서와 k=10은 모든 제품에서 같았습니다. 각 제품은 같은 host에서
하나씩 실행했으며 server·client CPU 및 memory 한도와 CPU frequency policy를 통일했습니다.
통신에는 제품별 native protocol을 사용했습니다. HNSW는 모두 M=24,
ef_construction=200으로 생성했습니다.
| 항목 | 조건 |
|---|---|
| Dataset | GIST1M: 960-dimensional float32 vector 1,000,000개, official query 1,000개. SIFT1M: 128-dimensional float32 vector 1,000,000개, official query 10,000개 |
| Recall@10 | 공통 1,000-query 표본에서 원본 vector의 exact squared Euclidean distance (L2)로 계산한 동점 허용 평균. 중복 ID를 제외하고 10번째 ground-truth distance와 같은 결과를 정답으로 처리 |
| QPS | Client 하나가 top-10 query 10,000개를 순차 전송. 완료 query 수를 측정 시간으로 나눈 값으로, serialization·전송·server decode·ANN search·결과 수신 포함 |
| 반복 | 동일 index에서 search width 순서를 바꾸어 반복 측정. Point는 QPS 중앙값, error bar는 측정 범위 |
| Segment | GIST1M: AkasicDB HNSW·Vamana 각 1개, Milvus Plain 4개, Milvus SQ·PQ 각 5개. SIFT1M: AkasicDB와 Milvus 모두 index 설정별 1개 |
| In-memory index | ANN warm-up query 없이 memory에 적재. Index 적재는 측정 구간에서 제외 |
| DiskANN | 각 point 전에 host page cache를 비우고 O_DIRECT로 graph를 읽은 cold condition. Cache 초기화는 측정 구간에서 제외 |
각 제품은 build 후 생성된 segment layout을 그대로 사용했습니다. Milvus는 한 query를 loaded segment별로 병렬 검색합니다. GIST1M Recall@10과 one-client QPS에는 이 multi-segment execution이 포함됩니다. 표의 값은 single-segment 구현 간 비교가 아닙니다.
HNSW search width ef_search와 Vamana·DiskANN search width L은 같은 값에서도 수행하는
작업이 다릅니다. 제품 또는 index family 간 QPS 비율은 Recall@10 차이가 0.5 percentage
points (pp) 이내인 point에만 계산했습니다. DiskANN과 in-memory index는 같은 chart에
표시하되 저장 상태가 달라 QPS 비율을 계산하지 않았습니다.
Plain은 quantization이 없는 index입니다. SQ/PQ 비교 단위는 quantizer가 아니라 전체 index
설정입니다. 제품별 압축 형식과 저장 크기는 동일하지 않습니다. AkasicDB series에는
Quantization의 HNSW와 Vamana 권장
profile을 적용했습니다.
GIST1M
Plain index
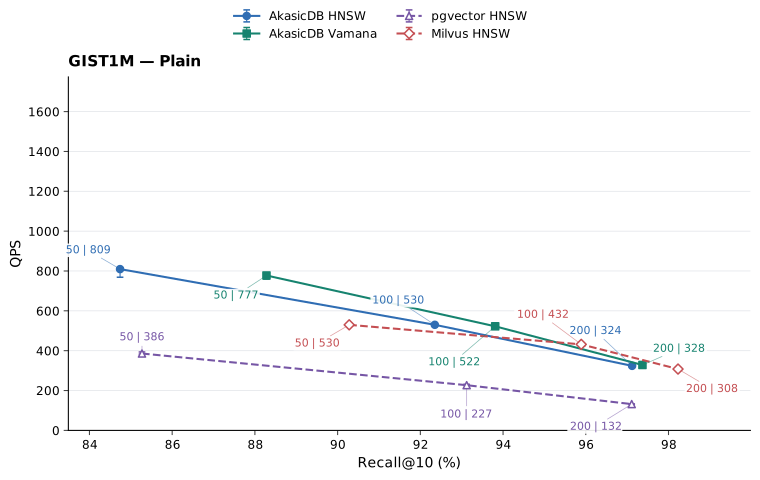
Figure 1. GIST1M Plain index. Label은 search width | QPS입니다.
Recall@10 차이가 0.5 pp 이내인 Plain 비교:
| 제품 / index | 검색 설정 | Recall@10 | QPS | 비교 |
|---|---|---|---|---|
| pgvector HNSW Plain | ef_search=200 |
97.11% | 131.848 | 기준 |
| AkasicDB HNSW Plain | ef_search=200 |
97.12% | 323.850 | pgvector 대비 2.456배; Recall 차이 0.01 pp |
| AkasicDB Vamana Plain | L=200 |
97.37% | 328.126 | pgvector 대비 2.489배; Recall 차이 0.26 pp |
Scalar quantization
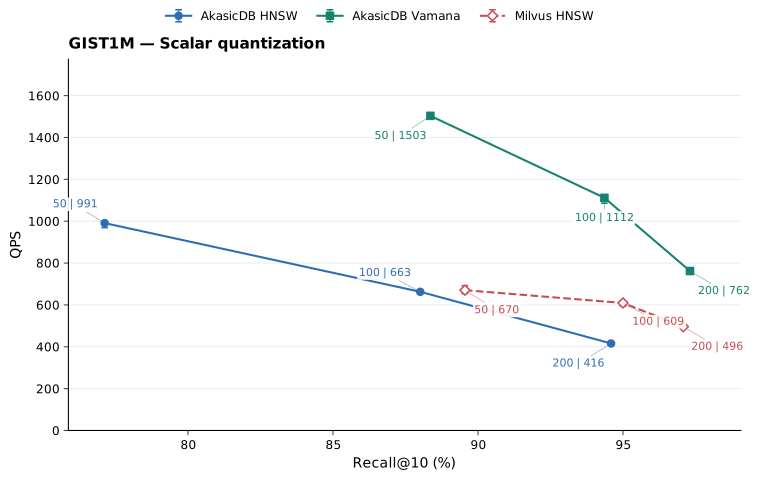
Figure 2. GIST1M scalar quantization. AkasicDB HNSW는 SQ4, AkasicDB Vamana는 ProjectedMinMax8, Milvus HNSW는 SQ4U와 32-bit floating-point (FP32) refine을 사용했습니다.
| 제품 / index | 검색 설정 | Recall@10 | QPS | 비교 |
|---|---|---|---|---|
| Milvus HNSW SQ4U | ef_search=200 |
97.08% | 496.138 | 기준 |
| AkasicDB Vamana ProjectedMinMax8 | L=200 |
97.31% | 761.938 | Milvus 대비 1.536배; Recall 차이 0.23 pp |
Product quantization과 DiskANN
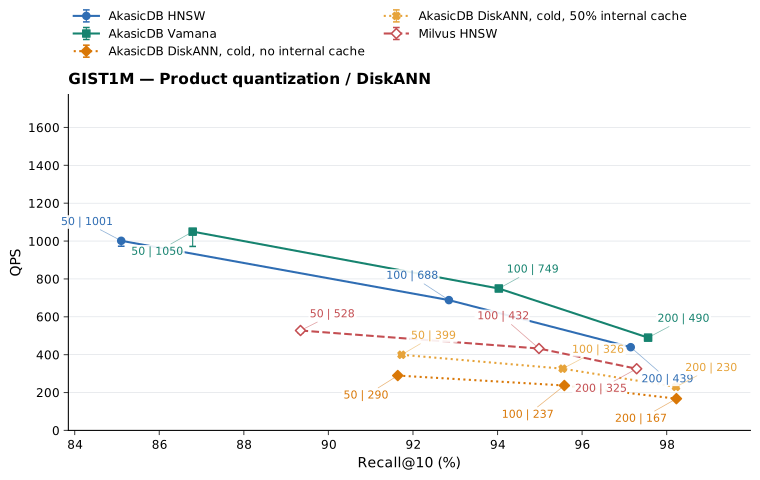
Figure 3. GIST1M product quantization과 DiskANN. AkasicDB HNSW는 PQ8 ratio=4,
AkasicDB Vamana는 PQ8 ratio=6을 사용했습니다. DiskANN은 cold condition에서 측정했습니다.
같은 width의 Plain 대비 PQ QPS는 AkasicDB HNSW에서 23.71–35.67%, AkasicDB Vamana에서 35.07–49.28% 높았습니다. Recall 변화는 각각 +0.03–+0.50 pp와 −1.49–+0.22 pp였습니다.
| DiskANN 설정 | L=50 Recall@10 / QPS |
L=100 Recall@10 / QPS |
L=200 Recall@10 / QPS |
|---|---|---|---|
| Internal cache 없음 | 91.64% / 289.569 | 95.58% / 237.070 | 98.23% / 167.432 |
cache_nodes=500000 |
91.73% / 399.337 | 95.54% / 325.872 | 98.22% / 229.786 |
SIFT1M
Plain index
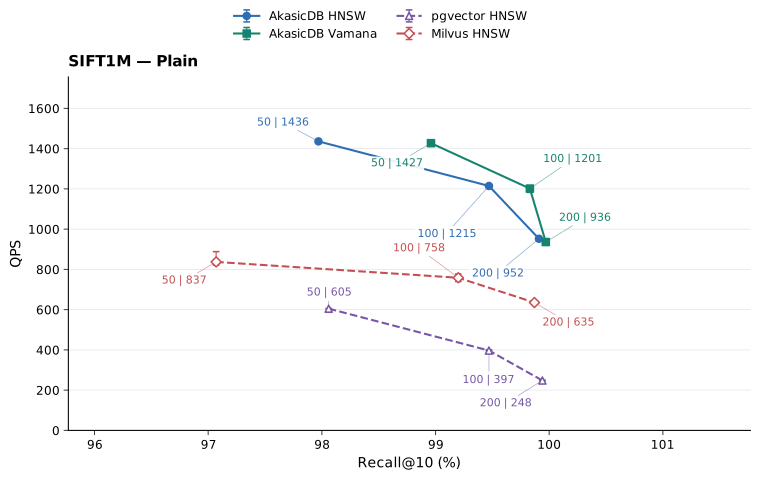
Figure 4. SIFT1M Plain index. Label은 search width | QPS입니다.
| 제품 / index | 검색 설정 | Recall@10 | QPS | 비교 |
|---|---|---|---|---|
| pgvector HNSW Plain | ef_search=100 |
99.47% | 396.701 | 기준 |
| AkasicDB HNSW Plain | ef_search=100 |
99.47% | 1214.514 | pgvector 대비 3.062배; Recall 차이 0.00 pp |
| Milvus HNSW Plain | ef_search=200 |
99.87% | 635.153 | 기준 |
| AkasicDB HNSW Plain | ef_search=200 |
99.91% | 952.188 | Milvus 대비 1.499배; Recall 차이 0.04 pp |
| AkasicDB Vamana Plain | L=100 |
99.83% | 1201.449 | Milvus 대비 1.892배; Recall 차이 0.04 pp |
Scalar quantization
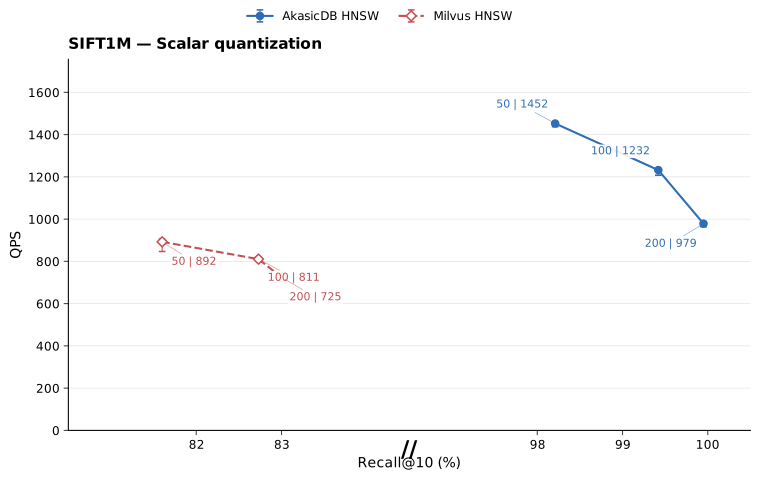
Figure 5. SIFT1M scalar quantization. AkasicDB HNSW SQ4의 QPS는 같은 width의 Plain보다 1.15–2.77% 높았고 Recall 차이는 −0.05–+0.24 pp였습니다. ProjectedMinMax8의 차원 하한은 161이므로 128-dimensional SIFT1M에는 적용하지 않았습니다.
Product quantization과 DiskANN
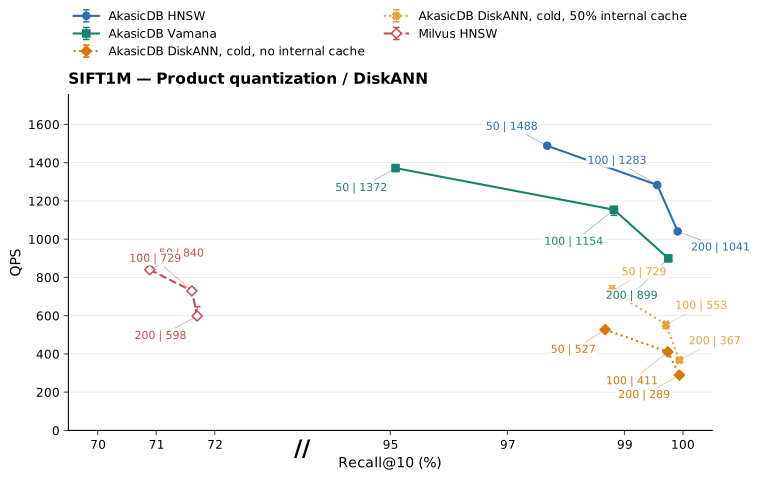
Figure 6. SIFT1M product quantization과 DiskANN. AkasicDB HNSW PQ8 ratio=4의 QPS는
같은 width의 Plain보다 3.65–9.29% 높았고 Recall 차이는 −0.29–+0.09 pp였습니다.
AkasicDB Vamana PQ8 ratio=6의 Recall과 QPS는 Plain보다 낮았습니다. DiskANN은 cold
condition에서 측정했습니다.
| DiskANN 설정 | L=50 Recall@10 / QPS |
L=100 Recall@10 / QPS |
L=200 Recall@10 / QPS |
|---|---|---|---|
| Internal cache 없음 | 98.67% / 527.020 | 99.74% / 410.937 | 99.94% / 289.283 |
cache_nodes=500000 |
98.79% / 728.548 | 99.71% / 553.036 | 99.94% / 367.385 |